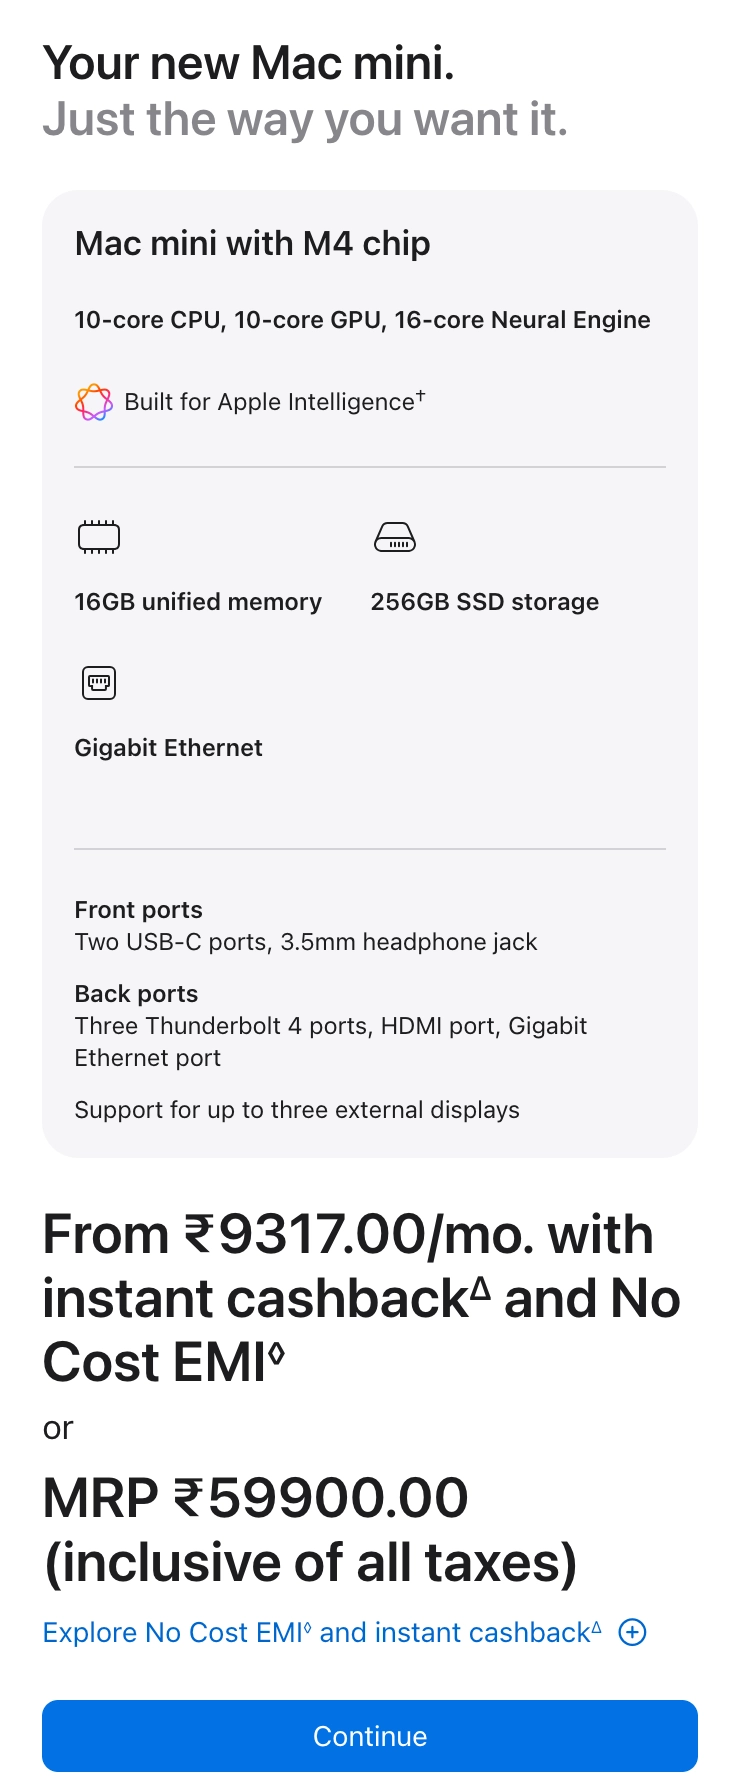
Faire tourner un LLM (Large Language Model) en local sur Mac mini, c est devenu réaliste et excellent en 2026. Avec 48-64 Go RAM unifiée et le Neural Engine Apple Silicon, ton Mac mini gère Llama 3 70B, Mistral Large, ou Qwen 2.5 sans cloud. Voici comment démarrer et optimiser ton setup LLM local.
📌 L’essentiel : un Mac mini Apple Silicon (M2 Pro à M4 Pro) fait tourner les meilleurs LLM open source en local. Llama 3 70B sur Mac mini M4 Pro 48 Go : 9 tokens/sec. Mistral Large : 7 t/s. Qwen 2.5 : 12 t/s. Investissement initial 1 999 € pour M4 Pro 48 Go, conso annuelle 50 €. Alternative crédible aux abonnements ChatGPT Plus, Claude Pro, ou API payantes.
Les meilleurs LLM open source en 2026
Quatre modèles dominent le marché open source. Llama 3 70B (Meta, le plus polyvalent). Mistral Large (Mistral AI, excellent en français). Qwen 2.5 72B (Alibaba, très bon en code). DeepSeek V3 (China, équivalent GPT-4 en raisonnement). Tous tournent sur Mac mini M4 Pro avec MLX. Compte 40-80 Go de stockage par modèle quantifié.
Comment installer un LLM local
La méthode la plus simple : Ollama. Installation via brew install ollama (ou télécharge depuis ollama.com). Puis dans le terminal : ollama run llama3:70b. Le téléchargement initial prend 15-20 minutes (40 Go), puis tu peux poser tes questions directement. Pour une interface graphique, ajoute Open WebUI ou Msty. Total temps de setup : 30 minutes pour quelqu un qui a déjà bidouillé du terminal.
💡 Bon à savoir : les modèles LLM sur Mac mini utilisent la quantification (4-bit ou 5-bit) pour tenir en RAM unifiée. C est pourquoi un modèle 70B (qui pèserait 140 Go en FP16) tient en 40-50 Go en quantifié 4-bit. La perte de qualité est minime (1-2% sur les benchmarks) et invisible en usage quotidien.
LLM local vs ChatGPT Plus
✅ Atouts LLM local
- Confidentialité totale
- Pas d abonnement mensuel
- Pas de limite d usage
⚠️ Limites
- Investissement initial 2 000 €
- Vitesse 3-5x inférieure à ChatGPT
- Maintenance et updates manuels
Optimiser les performances
Trois astuces pour booster ton LLM local. Premièrement, utilise MLX au lieu de PyTorch : 2x plus rapide sur Apple Silicon. Deuxièmement, choisis bien la quantification (Q4_K_M est le sweet spot qualité/vitesse). Troisièmement, désactive Spotlight indexation et autres apps en arrière-plan pour libérer de la RAM. Sur Mac mini M4 Pro 48 Go, ces optimisations peuvent gagner 30-40% de vitesse.
🛠️ Mon retour perso : j utilise Llama 3 70B en local sur Mac mini M4 Pro 48 Go depuis 8 mois. 9 tokens/sec en moyenne, suffisant pour ma rédaction et mon code. Pour des questions complexes, j attends 10-15 sec, acceptable. Confidentialité totale, pas de limite d usage. La leçon : pour un usage pro régulier, le LLM local est devenu une vraie alternative en 2026, pas juste un gadget pour geeks.
Le piège du sous-équipement
Pour Llama 3 70B en quantification 4-bit, il faut MINIMUM 40 Go de RAM disponible. Avec 48 Go RAM partagés (macOS prend 6-8 Go), ça passe juste. Avec 32 Go, tu te limites à des modèles 30B-32B (qualité moindre). Avec 16 Go, oublie les LLM sérieux. Investis dans 48 Go minimum pour de l usage 70B+ régulier.
🚫 Erreur fréquente : prendre Mac mini M4 24 Go pensant que ça suffira pour Llama 3 70B. Faux : 24 Go, c est juste pour les modèles 13B-30B max. Pour 70B, vise 48 Go minimum. La RAM est soudée, donc choix définitif à l achat. Investissement de 400-500 € de plus largement justifié pour un usage IA sérieux.
Setup débutant LLM local
Pour démarrer en 30 minutes : Mac mini M4 Pro 48 Go (1 999 €), Ollama installé, Llama 3 70B téléchargé, Open WebUI configuré. Tu accèdes à ton LLM via navigateur depuis n importe quel appareil de ton réseau local. Compatible avec apps tierces qui supportent OpenAI API (Cursor, Continue, etc.).
🛠️ Setup LLM débutant : Mac mini M4 Pro 48 Go (1 999 €), Ollama (gratuit), Open WebUI (gratuit), Llama 3 70B (gratuit, 40 Go disque). Total 1 999 €. Comparé à ChatGPT Plus à 23 €/mois sur 5 ans (1 380 €), tu économises peu en cash mais gagnes énormément en confidentialité et zéro limite d usage.
🎯 Cas d usage typique : avocat ou consultant qui traite des documents confidentiels et veut utiliser un LLM sans envoyer ses données dans le cloud. Mac mini M4 Pro 48 Go avec Llama 3 70B local. Confidentialité totale (RGPD respecté), pas de limite d usage, pas d abonnement. Investissement amorti en 18-24 mois vs ChatGPT Pro avec garanties enterprise.
Pour creuser plus loin, on a un papier sur le Mac mini en serveur IA partagé. Si tu veux comprendre l architecture, regarde notre Mac mini Apple Silicon en IA. Et pour un setup pro complet, l article sur le Mac mini M4 Pro pour usage pro détaille les configs.
Quel Mac mini pour faire tourner Llama 3 70B en local ?
Mac mini M4 Pro 48 Go (1 999 €) au minimum. Performances : 9 tokens/sec, qualité comparable à GPT-4 sur 90% des tâches. Pour une marge de confort, vise 64 Go (2 499 €). Avec 32 Go ou moins, tu es limité aux modèles 30B max.
LLM local Mac mini ou ChatGPT Plus ?
Pour confidentialité et usage intensif sans limite, le LLM local gagne. Pour qualité maximale et vitesse pure, ChatGPT Plus reste meilleur (3-5x plus rapide). Le coût total sur 5 ans est similaire (2 000 € vs 1 380 €), mais le local offre confidentialité totale.
Combien de temps pour installer un LLM sur Mac mini ?
30 minutes pour quelqu un qui a déjà bidouillé un terminal. Installation Ollama (5 min), téléchargement modèle Llama 3 70B (15-20 min selon réseau), configuration Open WebUI (5-10 min). Setup complet sans configuration avancée.
Quels logiciels pour LLM local sur Mac ?
Ollama (gratuit, CLI), LM Studio (gratuit, interface graphique), Msty (interface plus moderne), Open WebUI (interface ChatGPT-like accessible en réseau). Tous gratuits, optimisés Apple Silicon via MLX. Choix selon ton confort avec le terminal.